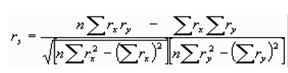Mostrando entradas con la etiqueta Bondad del Ajuste. Mostrar todas las entradas

martes, 28 de abril de 2015

Test Estadísticos: Test de Chi al Cuadrado (Ji-Cuadrado)


La prueba de Ji-cuadrado determina si existe asociación entre variables cualitativas. Se utiliza para analizar tablas de contingencia y comparación de proporciones en datos independientes.
Existen diferentes procedimientos estadísticos para el análisis de las tablas de contingencia como la prueba ji-cuadrado, la prueba exacta de fisher, la prueba de McNemar o la prueba Q de Cochran, entre otras. En este artículo se expondrá el cálculo e interpretación de la prueba como método estándar de análisis en el caso de grupos independientes.
La prueba permite determinar si dos variables cualitativas están o no asociadas. Si al final del estudio concluimos que las variables no están relacionadas podremos decir con un determinado nivel de confianza, previamente fijado, que ambas son independientes.
En la investigación médica o de mercados nos encontramos con frecuencia con datos o variables de tipo cualitativo, mediante las cuales un grupo de individuos se clasifican en dos o más categorías mutuamente excluyentes. Las proporciones son una forma habitual de expresar frecuencias cuando la variable objeto de estudio tiene dos posibles respuestas, como presentar o no un evento de interés (enfermedad, compra, , etc.).

lunes, 8 de septiembre de 2014

Pruebas No Paramétricas

El análisis de la varianza asume que las distribuciones subyacentes están distribuidas normalmente y que las variaciones de las distribuciones que son comparadas son similares.

El coeficiente de correlación de Pearson asume normalidad.


Mientras que las técnicas paramétricas son robustas (es decir, conservan a menudo un poder considerable para detectar diferencias o semejanzas incluso cuando se violan estas asunciones), algunas distribuciones no cumplen las características necesarias, por lo que una alternativa no paramétrica es más deseable para detectar una diferencia o una semejanza.


Pruebas no paramétricas para muestras relacionadas


viernes, 25 de julio de 2014

Test Estadísticos: Ejemplo del Test de Correlación de Pearson

Como vimos en una entrada anterior, el test de correlación de Pearson mide la relación  existente entre dos variables, su intensidad y su sentido (positivo o negativo).

A continuación veremos un ejemplo de su aplicación:

El Equipo Directivo de una empresa está interesado en conocer la relación que existe entre el tiempo semanal (horas) que dedican los trabajadores a formación y la productividad media de los mismos al final del año. Eligiendo 11 trabajadores al azar, han encontrado los siguientes resultados tras calcular el coeficiente de correlación de Pearson.

Media:


Como se puede ver en la tabla inferior  se muestran los resultados de x e y que son puntuaciones diferenciales que se han conseguido restándoles las medias a las puntuaciones directas. El valor de la media en cada una de las variables las mostraré a continuación junto con las operaciones para calcular la covarianza de cada variable.


Covarianza:


El resultado de la covarianza al ser positivo, nos indica cierta tendencia a que a un tiempo semanal de estudio por encima de la media corresponden calificaciones por encima de la media, y a un tiempo de estudio por debajo de la media corresponden calificaciones por debajo de la media.
Para calcular el coeficiente de correlación de Pearson nos ayudarán los resultados del ejercicio anterior. Pero además tendremos que calcular la desviación típica de x e y. Y para la desviación típica necesitaremos los resultados de la varianza de x e y respectivamente. Mostraré a continuación el procedimiento y los resultados del proceso necesario para obtener lo solicitado por el problema.
 

Viendo los resultados llegamos a la conclusión de que estamos ante una correlación muy alta, lo que quiere decir a puntuaciones altas en cuanto a notas se corresponden altas horas de trabajo y estudio semanal.


miércoles, 4 de septiembre de 2013

Test Estadísticos: Test de Correlación de Pearson

Hablamos de correlación cuando nos referimos a la relación  existente entre dos variables, su intensidad y su sentido (positivo o negativo).

La covarianza definida anteriormente como promedio de desviaciones conjuntas de dos variables sobre sus respectivas medias, no resulta ser una medida adecuada de la relación entre dos variables, pues el valor de Sxy está relacionado con el valor de la media de X y con el valor de la media de Y. por este motivo, si cambiamos la unidad de medida, la covarianza se vera modificada.

Podemos afirmar que el valor de la covarianza depende de la unidad de medida. Para evitar el efecto de la unidad de medida sobre Sxy podemos dividir las puntuaciones diferenciales por las respectivas desviaciones típicas Sx y Sy. El nuevo índice de relación que obtengamos tendrá la ventaja de ser invariante ante cualquier cambio en la unidad de medida. A este índice de correlación se le denomina coeficiente de correlación de Pearson o también coeficiente de correlación producto momento.


Aplicar el coeficiente de correlación de Pearson exige que las variables estén medidas al menos en una escala de intervalos y que se de una relación lineal entre ellas. Es decir, que los puntos del diagrama de dispersión se posicionen en la forma aproximada de una línea recta. Por tanto, usar el coeficiente de correlación de Pearson presupone la sospecha de que entre los grupos de puntuaciones se da una relación lineal.
El valor del coeficiente de correlación de Pearson se encuentra comprendido entre -1 y 1.
•    Valores próximos a 1 indicarán fuerte asociación lineal positiva.
•    Valores próxi¬mos a -1 indicarán fuerte asociación lineal negativa.
•    Valores próximos a 0 indicarán no asociación lineal, lo que no significa que no pueda existir otro tipo de asociación.

Resulta difícil precisar a partir de que valor de rxy podemos considerar que existe una correlación lineal entre dos variables. Siempre debemos tener en cuenta para la interpretación el tipo de variables a las que se aplica. Sin embargo, para tener un referente, y siendo conscientes de que estos coeficientes no son aplicables a todas las situaciones, tomamos los determinados por Bisquerra:


Además debemos tener presente que la existencia de una correlación no implica que necesariamente deba existir una relación causal directa. Por relación causal directa se entiende que si X e Y están correlacionadas, entonces X es en gran parte la causa de Y, o Y es en parte la causa de X.
No obstante, es habitual que tras encontrar una elevada correlación entre variables se hipoteticen relaciones causa efecto. Pero la existencia de una relación de este tipo habrá de ser comprobada recurriendo a otras estrategias de investigación y a otras técnicas estadísticas.


miércoles, 23 de enero de 2013

Test Estadísticos: Mann Whitney y Kruskal Wallis

Continuamos con la serie de artículos sobre test estadísticos. En semanas anteriores hemos escrito sobre la prueba t-Student, Spearman, Wilcoxon, Shapiro-Wilks,  Prueba F, Chi-Cuadrado, Fisher, McNemar, Binomial, Correlación de Pearson,  ahora escribiremos la teoría de los test de Mann-Whitney y Kruskal Wallis.

MANN-WHITNEY
 
La prueba de Mann-Whitney U es una de las pruebas de significación más conocidas. Es apropiada cuando dos muestras independientes de observaciones se miden en un nivel ordinal, es decir que podemos decir cuál es la mayor de estas dos observaciones.

Determina si el grado de coincidencia entre dos distribuciones observadas es inferior a la esperada por suerte en la hipótesis nula que las dos muestras vienen de una misma población.

Prueba de significación estadística no paramétrica para probar la hipótesis nula de que el parámetro de localización (generalmente la mediana) es el mismo cuando se comparan dos grupos independientes, cualquiera que sea el tipo de distribución de la variable (distribución normal o de otro tipo).

Se usa cuando se quiere comparar dos poblaciones usando muestras independientes, es decir, es una prueba alternativa a la prueba de t para comparar dos medias usando muestras independientes.

La hipótesis nula es que la mediana de las dos poblaciones son iguales y la hipótesis alterna puede ser que la mediana de la población 1 sea mayor (menor ó distinta) de la mediana de la población 2.

Prueba de Mann-Whitney para muestras independientes:

•    Si tenemos dos series de valores de una variable continua obtenidas en dos muestras independientes: X1, X2,..., Xn, Y1, Y2,..., Ym, procederemos a ordenar conjuntamente todos los valores en sentido creciente, asignándoles su rango, corrigiendo con el rango medio los empates.
•    Calculamos luego la suma de rangos para las observaciones de la primera muestra Sx, y la suma de rangos de la segunda muestra Sy.
•    Si los valores de la población de la que se extrajo la muestra aleatoria de X se localizan por debajo de los valores de Y, entonces la muestra de X tendrá probablemente rangos más bajos, lo que se reflejará en un valor menor de Sx del teóricamente probable.
•    Si la menor de las sumas de rangos es excesivamente baja, muy improbable en el caso de que fuera cierta la hipótesis nula, ésta será rechazada. 


KRUSKAL-WALLIS
 
Prueba de significación estadística no paramétrica para contrastar la hipótesis nula cuando los parámetros de localización de dos o más grupos son iguales.
La prueba de Kruskal-Wallis, es una alternativa a la prueba F del análisis de varianza para diseños de clasificación simple. En este caso se comparan varios grupos pero usando la mediana de cada uno de ellos, en lugar de las medias.

En este caso se comparan varios grupos pero usando la mediana de cada uno de ellos, en lugar de las medias.
•    Ho: La mediana de las k poblaciones consideradas son iguales y,
•    Ha: Al menos una de las poblaciones tiene mediana distinta a las otras.
 

Donde, n es el total de datos.

Este contraste, que es válido únicamente para variables continuas, compara la función de distribución (probabilidad acumulada) teórica con la observada, y calcula un valor de discrepancia, representado habitualmente como D, que corresponde a la discrepancia máxima en valor absoluto entre la distribución observada y la distribución teórica, proporcionando asimismo un valor de probabilidad P, que corresponde, si estamos verificando un ajuste a la distribución normal, a la probabilidad de obtener una distribución que discrepe tanto como la observada si verdaderamente se hubiera obtenido una muestra aleatoria, de tamaño n, de una distribución normal.
 
Si esa probabilidad es grande no habrá por tanto razones estadísticas para suponer que nuestros datos no proceden de una distribución, mientras que si es muy pequeña, no será aceptable suponer ese modelo probabilístico para los datos.

viernes, 18 de enero de 2013

Prueba Estadística “t” de Student

Continuando con la serie de entradas sobre los diferentes test estadísticos (ver las ya publicadas en en el Blog: Spearman, Wilcoxon y Shapiro-Wilks, prueba de F, Chi Cuadrado, Fisher, McNemar, Binomial, Correlación De Pearson), nos llega el turno de estudiar la prueba t de Student.

¿Qué hay que saber de la "t" de Student? 

Se utiliza para determinar si hay una diferencia significativa entre las medias de dos grupos, es decir que se utiliza cuando deseamos comparar dos medias.
Se utiliza para la comparación de dos medias de poblaciones independientes y normales.
Asumimos que las variables dependientes tienen una distribución normal. 

Especificamos el nivel de la probabilidad (nivel de la alfa, nivel de la significación, p) que estamos dispuestos a aceptar  (p < .05 es un valor común que se utiliza).
  • Con una prueba t, tenemos una variable independiente y una dependiente.
  • La variable independiente (por ejemplo sexo) solo puede tener dos niveles (hombre y mujer).
  • Si la independiente tuviera más de dos niveles, después utilizaríamos un análisis de la variación unidireccional (ANOVA).
  • La prueba estadística para t de Student es el valor t. Conceptualmente, la t-valor representa el número de unidades estándares que están separando las medias de los dos grupos.
  • Si nuestra t-prueba produce una t-valor que da lugar a una probabilidad de .01, decimos que la probabilidad de conseguir la diferencia que encontramos sería por casualidad de 1 de cada 100 veces.

Cuatro factores contribuyen para indicar si la diferencia entre dos medias de los grupos se puede considerar significativa:
  • Cuanto mayor es la diferencia entre las dos medias, mayor es la probabilidad que una diferencia estadística significativa existe.
  • El tamaño de la muestra es extremadamente importante en la determinación de la significación de la diferencia entre las medias. Aumentando el tamaño de la muestra, las medias tienden a ser más estables y más representativas.
  • Un nivel más grande de la alfa requiere menos diferencia entre las medias (p <0 font="font">.05). 
  •  Se debe utilizar una hipótesis (con dos colas) no directivas.

Asunciones subyacentes la prueba de t:
  • Las muestras se han dibujado aleatoriamente a partir de sus poblaciones respectivas.
  • La población se debe distribuir normalmente.
  • Unimodal (un modo).
  • Simétrico (las mitades izquierdas y derechas son imágenes espejo), el mismo número de gente arriba o abajo de la media.
  • Acampanado (altura máxima (moda) en el medio).
  • Media, moda, y mediana se localizan en el centro.
  • Asintótico (cuanto más lejos se aleja la curva de la media, más cercana será el eje de X; pero la curva nunca debe tocar el eje de X).
  • El número de personas en las poblaciones debe tener la misma varianza (s2 = s2).Si no es el caso se utiliza otro cálculo para el error estándar.

Existen 2 tipos de prueba t de Student

  • Test t para diferencia par ( grupos dependientes, test t correlacionado) : df= n (número de pares) -1

Esto se refiere a la diferencia entre las cuentas medias de una sola muestra de individuos que se determina antes del tratamiento y después del tratamiento. Puede también comparar las cuentas medias de muestras de individuos que se aparean de cierta manera (por ejemplo los hermanos, madres, hijas, las personas que se emparejan en términos de las características particulares).
  • Test t para muestras independientes
Esto se refiere a la diferencia entre los promedios de dos poblaciones.

Básicamente, el procedimiento compara los promedios de dos muestras que fueron seleccionadas independientemente una de la otra.

Un ejemplo sería comparar cuentas matemáticas de un grupo experimental con un grupo de control.
¿Cómo decido qué tipo de t-prueba a utilizar?

Error tipo I:
  • Rechaza una hipótesis nula que sea realmente verdad. La probabilidad de hacer un error tipo I depende del nivel alfa que se seleccionó.
  • Si se fijó la probabilidad alfa en p < 05, entonces existe un 5% de posibilidades de hacer un error de tipo I.
  • Se puede reducir la posibilidad de hacer un error tipo I fijando un nivel alfa más pequeño (p < .01). El problema haciendo esto es que se aumenta la posibilidad de un error tipo II.
Error tipo II:
  • Falla en rechazar una hipótesis nula que sea falsa.
  • La idea básica para calcular una prueba de Student es encontrar la diferencia entre las medias de los dos grupos y dividirla por el error estándar (de la diferencia), es decir la desviación de estándar de la distribución de las diferencias.
  • Un intervalo de confianza para una prueba t con dos colas es calculado multiplicando los valores críticos por el error de estándar y agregando y restando eso de la diferencia de las dos medias.
  • El efecto tamaño se utiliza para calcular la diferencia práctica. Si existen varios miles de pacientes, es muy fácil encontrar una diferencia estadísticamente significativa
Saber si esa diferencia es práctica o significativa es otra pregunta. 
  • Con los estudios implicando diferencias de grupo, el tamaño del efecto es la diferencia de las dos medias dividido por la desviación estándar del grupo control (o la desviación estándar media de ambos grupos si no hay grupo de control).
  • Generalmente, el tamaño del efecto es solamente importante si existe una significación estadística.
  • Un efecto tamaño de 2 se considera pequeño, 5 se considera medio, y 8 se considera grande.
¿Quieres ayudarnos a mantener vivo el blog?

miércoles, 9 de enero de 2013

Test Estadísticos: Spearman, Wilcoxon y Shapiro-Wilks

Hace unos días escribimos un post sobre algunos de los principales test estadísticos (Prueba de F, Chi Cuadrado, Fisher, McNemar, Binomial, Correlación de Pearson). En el post actual hablaremos brevemente del test de correlación de Spearman, Wilcoxon y Shapiro Willks.

TEST DE CORRELACIÓN DE SPEARMAN
Es una medición no paramétrica de correlación, asume una función monotónica arbitraria para describir la relación entre dos variables, sin hacer ningunas asunciones sobre la distribución de frecuencia de las variables.
A la diferencia del coeficiente del test de Pearson, no requiere la asunción que la relación entre las variables es linear, ni que las variables sean medidas en escalas del intervalo; puede ser utilizado para variables medidas en nivel ordinal.
Se utiliza si no se cumplen las condiciones de aplicación del test de Pearson.
Es una variante del test de correlación de Pearson se aplica cuando cada valor en sí no es tan importante como su situación respecto a los restantes.
Sus valores se interpretan exactamente igual que los del coeficiente de correlación de Pearson.
La correlación de Spearman mide el grado de asociación entre dos variables cuantitativas que siguen una tendencia siempre creciente o siempre decreciente.
Es más general que el Coeficiente de correlación de Pearson, la correlación de Spearman, en cambio se puede calcular para relaciones exponenciales o logarítmicas entre las variables.

TEST DE WILCOXON
Contrasta la hipótesis nula de que la muestra procede de una población en la que la magnitud de las diferencias positivas y negativas entre los valores de las variables es la misma.
Prueba estadística no paramétrica para la comparación de dos muestras (dos tratamientos).
Las distribuciones de datos no necesitan seguir la distribución normal.
Es por tanto una prueba menos restrictiva que la prueba t-Student.

PRUEBA DE SHAPIRO-WILKS.
Aunque esta prueba es menos conocida es la que se recomienda para contrastar el ajuste de nuestros datos a una distribución normal, sobre todo cuando la muestra es pequeña (n<30 font="font">
Mide el ajuste de la muestra a una recta, al dibujarla en papel probabilístico normal.

jueves, 29 de noviembre de 2012

Test Estadísticos: Prueba de F, Chi Cuadrado, Fisher, McNemar, Binomial, Correlación de Pearson

PRUEBA DE F
  • Prueba estadística que sirve para comparar varianzas.
  • El estadístico F experimental es el estadístico de contraste en el ANOVA y otras pruebas de comparación de varianzas.
TEST DE CHI AL CUADRADO
  • La prueba de Ji-cuadrado es cualquier prueba estadística de la hipótesis en cuál el test estadístico de la distribución del Ji-cuadrado si la hipótesis nula es verdad.
  • Determina si existe asociación entre variables cualitativas.
  • Si el p-valor asociado al estadístico de contraste es menor se rechazará la hipótesis nula.
  • Se utiliza para analizar tablas de contingencia y comparación de proporciones en datos independientes
PRUEBA EXACTA DE FISHER (p.- 5%)
  • Permite valorar el efecto del azar.
  • Es una prueba estadística de significación usada en el análisis de los tamaños pequeños categóricos de muestra de datos.
  • La necesidad de la prueba de Fischer se presenta cuando tenemos datos que se dividan en dos categorías de dos maneras separadas.
  • Prueba de significación estadística utilizada para comparar proporciones en tablas de contingencia.
  • Es preferible a la prueba de x2 cuando el tamaño de la muestra es reducido (de menos de 30 efectivos).
  • Es la prueba estadística de elección cuando la prueba de Chi cuadrado no puede ser empleada por tamaño muestral insuficiente
PRUEBA DE MCNEMAR.
  • Prueba estadística que sirve para comparar proporciones en datos pareados.
  • Prueba de significación estadística para probar la hipótesis nula de inexistencia de cambios en la proporción de sujetos que experimentan un acontecimiento, cuando cada individuo es evaluado dos veces (en condiciones diferentes) y los datos están emparejados.
PRUEBA BINOMIAL
  • En estadística, la prueba binomial es una prueba exacta de la significación estadística de desviaciones de una distribución teóricamente prevista de observaciones en dos categorías.
  • El uso más común de la prueba binomial es en el caso donde la hipótesis nula es que dos categorías son igualmente probables ocurrir.
TEST DE CORRELACIÓN DE PEARSON
  • Se utiliza para estudiar la asociación entre un factor de estudio y una variable de respuesta cuantitativa, mide el grado de asociación entre dos variables tomando valores entre -1 y 1.
  • Valores próximos a 1 indicarán fuerte asociación lineal positiva.
  • Valores próxi­mos a -1 indicarán fuerte asociación lineal negativa.
  • Valores próximos a 0 indicarán no asociación lineal, lo que no significa que no pueda existir otro tipo de asociación.
  • Prueba en una hipótesis nula que las frecuencias relativas de la ocurrencia de acontecimientos observados siguen una distribución de frecuencia especificada.
  • Los acontecimientos deben ser mutuamente exclusivos.
  • Es una prueba de la calidad de ajuste que establece sí o no una distribución de frecuencia observada diferencia de una distribución teórica.

miércoles, 17 de octubre de 2012

Test Estadísticos: Prueba de Kolmogorov-Smirnov

El test de Kolmogorov-Smirnov es una prueba de significación estadística no paramétrica utilizada para determinar la bondad del ajuste de dos distribuciones de probabilidad entre sí.

Es decir, trataremos de verificar si el conjunto de datos se puede ajustar o afirmar que proviene de una determinada distribución. Las pruebas estadísticas que tratan este problema reciben el nombre general de “Pruebas de Bondad de Ajuste”.

La Prueba de Kolmogorov-Smirnov  mide, el grado de ajuste que existe entre la distribución obtenida a partir de la muestra y la distribución teórica que se supone debe seguir esa muestra. Ambas pruebas están basadas en la hipótesis nula de que no hay diferencias significativas entre la distribución muestral y la teórica. Ambas pruebas están basadas en las siguientes hipótesis:
  • H0: f(x,q) = f0(x,q)
  • H1: f(x,q) <> f0(x,q)
donde f0(x,q) es la distribución que se supone sigue la muestra aleatoria. La hipótesis alternativa siempre se enuncia como que los datos no siguen la distribución supuesta. Si se desea examinar otra distribución específica, deberá realizarse de nuevo la otra prueba suponiendo que la hipótesis nula es esta nueva distribución. Al especificar la hipótesis nula, el conjunto de parámetros definidos por que puede ser conocido o desconocido. En caso de que los parámetros sean desconocidos, es necesario estimarlos mediante alguno de los métodos de estimación.

Para formular la hipótesis nula deberán tenerse en cuenta los siguientes aspectos o criterios:

a) La naturaleza de los datos a analizar. Por ejemplo, si tratamos de investigar la distribución que siguen los tiempos de fallo de unos componentes, podríamos pensar en una distribución exponencial, o una distribución gama o una distribución Weibull, pero en principio no consideraríamos una distribución normal. Si estamos analizando los caudales de un río en un determinado sitio, podríamos pensar en una distribución logarítmica normal, pero no en una distribución normal.

b) Histograma. La forma que tome el histograma de frecuencia es quizás la mejor indicación del tipo de distribución a considerar.

Este contraste, que es válido únicamente para variables continuas, compara la función de distribución (probabilidad acumulada) teórica con la observada, y calcula un valor de discrepancia, representado habitualmente como D, que corresponde a la discrepancia máxima en valor absoluto entre la distribución observada y la distribución teórica, proporcionando asimismo un valor de probabilidad P, que corresponde, si estamos verificando un ajuste a la distribución normal, a la probabilidad de obtener una distribución que discrepe tanto como la observada si verdaderamente se hubiera obtenido una muestra aleatoria, de tamaño n, de una distribución normal.

Si esa probabilidad es grande no habrá por tanto razones estadísticas para suponer que nuestros datos no proceden de una distribución, mientras que si es muy pequeña, no será aceptable suponer ese modelo probabilístico para los datos.