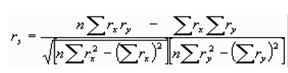miércoles, 6 de noviembre de 2013

¿Cuándo una diferencia entre medias es estadísticamente significativa?


La eterna pregunta: ¿Cuándo una diferencia entre medias es estadísticamente significativa? En cualquier análisis estadístico la información más habitual que se presenta en los informes es la Media Aritmética. Es un resultado sencillo y de fácil compresión, sin embargo, en multitud de foros y reuniones de trabajo surge la pregunta a la hora de comparar 2 medias.

Si estamos afirmando que A (sea una tienda, paciente, proveedor) vende un promedio de 140 unidades al mes este año y el año anterior vendía 149 … ¿Esta diferencia es estadísticamente significativa?
El resolver esta pregunta implica realizar un test de hipótesis ya que es la herramienta matemática que cuantifican hasta qué punto la variabilidad de la muestra puede ser responsable de los resultados de un estudio en particular. La Ho (hipótesis nula) representa la afirmación de que no hay asociación entre las dos variables estudiadas y la Ha (hipótesis alternativa) afirma que hay algún grado de relación o asociación.
Nuevamente la estadística nos muestra su utilidad ya que nos ayuda a tomar la decisión de que hipótesis debemos elegir. Dicha decisión puede ser afirmada con una seguridad que nosotros previamente decidimos y que denominamos Nivel de Significación.

¿Cómo se realiza un test de hipótesis?
Aunque con matices, se realizan de la siguiente forma. En primer lugar se mira la magnitud de la diferencia que hay entre los grupos a comparar (A y B). Si esta magnitud o valor absoluto es mayor que un error estándar definido multiplicado por una seguridad definida, concluimos que la diferencia es significativa entre A y B. Por tanto aceptamos la hipótesis alternativa y rechazamos la hipótesis nula.

Ejemplo:
Disponemos de 2 tratamientos ( A y B). El tratamiento A lo reciben 25 pacientes y el tratamiento B otros 25 pacientes. 15 pacientes responden favorablemente al tratamiento A y 20 al tratamiento B. ¿Existe diferencia significativa entre ambos tratamientos?
Ho (hipótesis nula) = No hay diferencia entre ambos tratamientos.
Ha (hipótesis alternativa) = Sí existe diferencia.


Error estándar * 1.96 = 0.1296 * 1.96 = 0.25

Como quiera que la diferencia =  | 0,60 - 0,80 | = 0,20


no supera el valor 0.25 concluimos que la diferencia entre 0.60 y 0.80 no es estadísticamente significativa. A la vista de los resultados no podemos aceptar la Ha (hipótesis alternativa).

El proceso de aceptación o rechazo de la hipótesis lleva implícito un riesgo que se cuantifica con el valor de la "p", que es la probabilidad de aceptar la hipótesis alternativa como cierta, cuando la cierta podría ser la hipótesis nula.

El valor de "p" que indica que la asociación es estadísticamente significativa ha sido arbitrariamente seleccionado y por consenso se considera en 0.05. Una seguridad del 95% lleva implícito una p < de 0.05 y una seguridad del 99% lleva implícita una p < 0.01. Cuando rechazamos la Ho (hipótesis nula) y aceptamos la Ha (hipótesis alternativa) como probablemente cierta afirmando que hay una asociación, o que hay diferencia, estamos diciendo en otras palabras que es muy poco probable que el azar fuese responsable de dicha asociación. Del mismo modo si la p>0.05 decimos que el azar no puede ser excluido como explicación de dicho hallazgo y no rechazamos la Ho (hipótesis nula) que afirma que ambas variables no están asociadas o correlacionadas.


lunes, 4 de noviembre de 2013

Cursos universitarios de Estadística, online y gratuitos

En los próximos días, diferentes universidades comenzarán una serie de interesantes cursos gratuitos, alguno de ellos relacionados con la estadística. Los cursos que presentamos aquí son en español y os aconsejamos que visitéis el enlance para conocer más detalles.


Estadística para investigadores: Todo lo que siempre quiso saber  (Universidad de Salamanca)
Es una excelente propuesta para aquellos que deseen iniciarse en los conceptos básicos de la Estadística. Dirigido a todo el mundo que tenga inquietudes en la interpretación de datos estadísticos. Además, es ideal para recordar y actualizar los conocimientos que ya tiene sobre estadística básica, proporcionándole un buena base para su investigación, de una manera muy sencilla de comprender.

Análisis Estadístico Básico con SPSS  (Universidad de Cantabria) 
El Curso pretende introducir al alumno en los aspectos básicos del manejo del SPSS y ver sus aplicaciones prácticas a los diseños de investigación más conocidos. Crear unas bases sólidas que permitan continuar al alumno ampliando su conocimiento del SPSS por si mismo.

Aprende Análisis Estadístico de Datos con R  (UCAM)
R es un entorno informático de computación estadística y de generación de gráficos. R funciona en un amplio rango de sistemas operativos como UNIX, Windows o MacOS. Pese a su potencialidad, versatilidad y flexibilidad; R puede parecer árido en el momento en que el usuario trata de interaccionar con sus componentes. Se suele decir que “la curva de aprendizaje es lenta”. Sin embargo, los resultados que produce son ampliamente satisfactorios. Este curso está destinado a “lubricar” esos primeros encuentros con éste entorno estadístico.


Curso Práctico de Bioestadística con R (Primera parte)  (Universidad San Pablo)
Curso de Estadística aplicada a las Ciencias de la Salud. En esta primera parte el curso se centrará en la estadística descriptiva de una o más variables y de sus relaciones. El curso también introducirá el manejo del programa de análisis de datos R y el paque rk.Teaching con el que se realizarán los análisis estadísticos.


¿Quieres ayudarnos a mantener vivo el blog?
 

jueves, 3 de octubre de 2013

Medir la incertidumbre con la estadística Bayesiana

¿Qué es la estadística Bayesiana? Vamos a tratar de explicar en qué consiste con un ejemplo. ¿Cuál es la probabilidad de que mañana llueva en Madrid? La "lluvia de mañana en Madrid" lo denominaremos evento A. La información que obtengamos de diferentes fuentes como institutos de meteorología con datos actuales y anteriores como la humedad, el clima regional, la presión, etc, se representan con B. 

La propuesta de Bayes es calcular cuál es la probabilidad de que llueva mañana dada la información de B. Tenemos unos datos y, dado que tenemos esa información, queremos calcular la probabilidad de algún evento. Con este desarrollo, Bayes fundó una manera de hacer estadística que hoy denominamos estadística bayesiana. 

Supongamos que los meteorólogos le asignan al evento A una probabilidad de 10%.¿qué quiere decir que la probabilidad de que llueva mañana es del 10%? La teoría bayesiana establece que esa probabilidad del 10% no representa una frecuencia, sino que es una medida de lo que conocemos nosotros, una magnitud de nuestra incertidumbre o de nuestra certeza. Si al evento "llueve mañana miércoles en la ciudad de Madrid" le asignamos una probabilidad de 10%, dados los datos que tenemos, esto significa que tenemos alguna certeza de que no va a llover mañana, que es poco probable. 

Para saber más puedes visitar la Wikipedia y su entrada sobre el Teorema de Bayes. 

Comprando directamente desde los enlaces inferiores, obtendrás el mejor precio y ayudarás a mantener nuestro blog:

miércoles, 4 de septiembre de 2013

Test Estadísticos: Test de Correlación de Pearson

Hablamos de correlación cuando nos referimos a la relación  existente entre dos variables, su intensidad y su sentido (positivo o negativo).

La covarianza definida anteriormente como promedio de desviaciones conjuntas de dos variables sobre sus respectivas medias, no resulta ser una medida adecuada de la relación entre dos variables, pues el valor de Sxy está relacionado con el valor de la media de X y con el valor de la media de Y. por este motivo, si cambiamos la unidad de medida, la covarianza se vera modificada.

Podemos afirmar que el valor de la covarianza depende de la unidad de medida. Para evitar el efecto de la unidad de medida sobre Sxy podemos dividir las puntuaciones diferenciales por las respectivas desviaciones típicas Sx y Sy. El nuevo índice de relación que obtengamos tendrá la ventaja de ser invariante ante cualquier cambio en la unidad de medida. A este índice de correlación se le denomina coeficiente de correlación de Pearson o también coeficiente de correlación producto momento.


Aplicar el coeficiente de correlación de Pearson exige que las variables estén medidas al menos en una escala de intervalos y que se de una relación lineal entre ellas. Es decir, que los puntos del diagrama de dispersión se posicionen en la forma aproximada de una línea recta. Por tanto, usar el coeficiente de correlación de Pearson presupone la sospecha de que entre los grupos de puntuaciones se da una relación lineal.
El valor del coeficiente de correlación de Pearson se encuentra comprendido entre -1 y 1.
•    Valores próximos a 1 indicarán fuerte asociación lineal positiva.
•    Valores próxi¬mos a -1 indicarán fuerte asociación lineal negativa.
•    Valores próximos a 0 indicarán no asociación lineal, lo que no significa que no pueda existir otro tipo de asociación.

Resulta difícil precisar a partir de que valor de rxy podemos considerar que existe una correlación lineal entre dos variables. Siempre debemos tener en cuenta para la interpretación el tipo de variables a las que se aplica. Sin embargo, para tener un referente, y siendo conscientes de que estos coeficientes no son aplicables a todas las situaciones, tomamos los determinados por Bisquerra:


Además debemos tener presente que la existencia de una correlación no implica que necesariamente deba existir una relación causal directa. Por relación causal directa se entiende que si X e Y están correlacionadas, entonces X es en gran parte la causa de Y, o Y es en parte la causa de X.
No obstante, es habitual que tras encontrar una elevada correlación entre variables se hipoteticen relaciones causa efecto. Pero la existencia de una relación de este tipo habrá de ser comprobada recurriendo a otras estrategias de investigación y a otras técnicas estadísticas.


lunes, 2 de septiembre de 2013

Hay trabajo para Matemáticos y Estadísticos

La Encuesta de Población Activa (EPA) realizada por el Instituto Nacional de Estadística trimestralmente además de conocer datos sobre el paro de los Españoles, permite analizar la principales actividades de ocupación. En su última entrega, los resultados demuestran que las especialidades de Matemáticas y Estadística, es la segunda especialidad con mayor tasa de empleo (la primera es Veterinaria). 

Más del 75% de los 101.400 personas adultas en España con estudios de Estadística y Matemáticas tienen empleo.


¿Quieres ayudarnos a mantener vivo el blog?